Quanta RAM precisa o teu portátil para correr IA localmente?
Um pequeno modelo de IA a correr no teu próprio portátil já consegue ler texto, interpretar imagens e responder às tuas perguntas, sem precisares de uma conta na nuvem. Hoje à noite, descarrega o qwen3.5:4b-q4_K_M (Qwen), cujo ficheiro ocupa 3,4 GB: este modelo consegue fazer exatamente isso num portátil normal com 16 GB de RAM. É um LLM, ou um grande modelo de linguagem. Descarrega-o com o Ollama, faz-lhe uma pergunta com contexto 4K e tens um modelo de IA a sério a correr no teu próprio equipamento. Lê texto e imagens, e aqui falamos de inferência, não de treino: ninguém está a ensinar nada de novo ao modelo, ele limita-se a responder.
Um autocolante vago com "AI PC" na caixa de um portátil não é uma especificação. O que conta é a RAM, a memória que a tua GPU consegue usar, o armazenamento e o suporte real de software. Os 16 GB de memória são um verdadeiro ponto de entrada para modelos pequenos de IA, não um mínimo irrelevante nem uma promessa de tudo o que aparece numa ficha técnica. Mais memória dá-te mais contexto e mais margem para multitarefa. Com 16 GB já consegues começar.
O que realmente ocupa a RAM do teu portátil quando corres IA
O tamanho do ficheiro que descarregas e a RAM que o modelo ocupa quando está a correr são duas coisas diferentes, e confundi-las é o erro mais comum ao comprar um portátil para IA. Os 3,4 GB que descarregas do qwen3.5:4b-q4_K_M são o ficheiro em disco. Para o carregar, é preciso memória a sério. O mesmo vale para a janela de contexto, ou seja, a conversa em curso que o modelo mantém presente enquanto responde, chamada cache KV. A isso somam-se o próprio motor e tudo o resto que o sistema operativo e outras aplicações já estiverem a usar.
Por defeito, o Ollama carrega um contexto de 4096 tokens, e podes aumentá-lo. Se correres vários pedidos ao mesmo tempo, a memória necessária para o contexto multiplica-se, em termos aproximados, pelo número de pedidos paralelos. A ficha técnica de um modelo pode anunciar uma janela de contexto de 128K ou 256K tokens: vê isso como o limite máximo do modelo, não como uma garantia de que o teu portátil com 16 GB consegue usar tudo de uma vez.
RAM, VRAM e memória unificada não são a mesma coisa
Os chips Apple Silicon usam memória unificada: CPU e GPU recorrem ao mesmo conjunto de 16, 24 ou 32 GB, por isso não existe uma memória gráfica separada que possa ficar sem espaço. Num portátil típico com Windows ou Linux e GPU dedicada da NVIDIA, a lógica é outra. A RAM do sistema e a VRAM da GPU são dois conjuntos separados, e 16 GB de RAM do sistema mais uma GPU com 8 GB não formam um único bloco de 24 GB que o modelo possa usar livremente.
Quando o modelo não cabe por completo na GPU, uma parte passa a correr na CPU, numa distribuição parcial da carga que pode tornar um modelo tecnicamente executável bastante mais lento na prática. Se usares , vês exatamente essa divisão entre CPU e GPU no que estiver carregado naquele momento.
A capacidade é só metade da história. A velocidade a que essa memória se move é igualmente importante: a Apple indica 153 GB/s de largura de banda de memória no MacBook Air M5, e é essa largura de banda, não apenas a capacidade, que explica em boa parte porque é que a memória unificada responde bem em vez de ser apenas suficiente no papel.
Quantização: como um modelo de IA de 9B encolhe para caber na RAM
A quantização está por trás daquele ficheiro de 3,4 GB: ao guardar os pesos do modelo com menor precisão numérica, o ficheiro fica mais pequeno, e o próprio modelo 9B do Qwen3.5 mostra bem essa diferença. O mesmo modelo 9B pesa 6,6 GB em Q4_K_M, 11 GB em Q8_0 e 19 GB em precisão BF16 total. É o mesmo modelo, com o mesmo número de parâmetros, mas com três tamanhos de download muito diferentes, e mais uma vez estamos a falar do ficheiro descarregado, não da RAM necessária durante a execução.
Em geral, menos precisão implica alguma perda de qualidade, e o impacto depende da tarefa, não de uma percentagem fixa. Há ainda um pormenor prático que convém saber antes de escolheres o Qwen como primeiro modelo: alguns utilizadores relatam que a etapa de "raciocínio" acrescenta um atraso visível antes de surgir a resposta, em comparação com modelos que respondem de forma mais direta. Vale a pena experimentares os dois estilos nas tuas tarefas, em vez de partires do princípio de que um é simplesmente melhor.
Já tens um MacBook com 16 GB? Experimenta isto antes de comprares o que quer que seja
Se já tens um MacBook com 16 GB, começa por um modelo de 2-4B em precisão Q4 e contexto 4K antes de pensares em comprar outra coisa. Um modelo 9B em Q4, ou algo como o Gemma 4 12B QAT, também poderá carregar. Se isso acontece ou não depende do número de aplicações abertas, da quantidade de contexto que estás a usar e da temperatura a que a máquina já está a trabalhar, por isso vê-o como algo que vale a pena testar, não como uma garantia.
Se estás a pensar comprar um portátil novo especificamente para isto, o MacBook Air de 13 polegadas com chip M5 vem com 16 GB de memória unificada de série e pode ser configurado até 32 GB. E antes que um ecrã maior te tente como upgrade: o Air M5 de 15 polegadas começa exatamente nas mesmas opções de memória, 16, 24 e 32 GB, e na mesma largura de banda de 153 GB/s do modelo de 13 polegadas. Escolhe o tamanho do ecrã pelo conforto, não por achares que te dá mais margem para IA. Não dá.

Já tens um portátil Windows ou Linux com 16 GB? Começa por aqui
Um portátil Windows ou Linux com 16 GB e sem GPU dedicada continua a conseguir correr um modelo pequeno. O Ollama funciona nativamente em Windows, por isso descarrega um modelo Q4 de 2-4B e testa-o primeiro na CPU ou nos gráficos integrados antes de gastares dinheiro. Conta com mais variação no resultado do que num Apple Silicon: não existe um valor fixo de tokens por segundo que sirva para todas as máquinas, porque ninguém mediu todas as configurações possíveis.
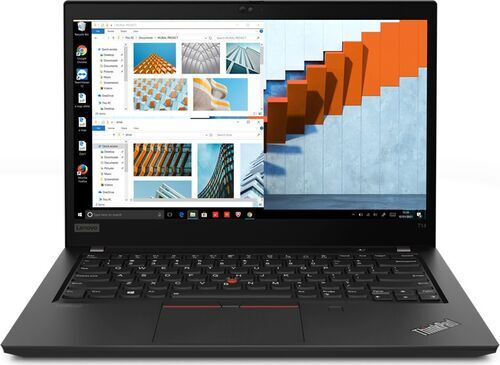
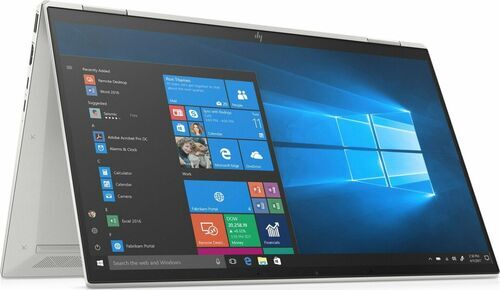
O Lenovo ThinkPad T14 G2 e o HP EliteBook x360 1040 G7 têm ambos 16 GB de RAM com gráficos integrados, exatamente neste nível. Há uma coisa que vale a pena confirmar primeiro, sobretudo numa máquina recondicionada mais antiga como qualquer uma destas: o LM Studio exige suporte AVX2 em Windows x64, um conjunto de instruções que nem todos os processadores mais antigos têm. Confirma se o teu processador específico o suporta antes de partires do princípio de que qualquer portátil desta gama consegue correr a ferramenta que escolheste.
A armadilha da nomenclatura das GPUs para portáteis: porque a "RTX 5070 Ti" não corresponde a um único número
As GPUs para portáteis da NVIDIA partilham o nome com as placas gráficas de secretária, mas esse nome diz menos do que parece. A RTX 5060 Laptop GPU tem 8 GB de memória GDDR7 e um intervalo de potência publicado entre 45 e 100 watts. A RTX 5070 Ti Laptop GPU tem 12 GB de GDDR7 e 60 a 115 watts. Um resultado online de uma RTX 5070 Ti para desktop não equivale ao de uma RTX 5070 Ti Laptop GPU, independentemente do que o nome sugere.
Há uma segunda armadilha escondida nesse mesmo nome. Dois portáteis podem ter ambos uma "RTX 5070 Ti Laptop GPU" e, ainda assim, comportarem-se de forma diferente em carga contínua: um chassis fino e leve e outro mais espesso e pesado dissipam o calor de maneira diferente, e o mesmo nome de GPU não garante a mesma velocidade real depois de as ventoinhas estarem a trabalhar há algum tempo. Verifica sempre o valor exato de VRAM e a configuração de potência do próprio portátil, não apenas o nome da família da GPU.
Se vais comprar um Mac novo, este é o nível de memória unificada mais confortável.
Se vais comprar um portátil especificamente para correr IA local com regularidade, 24 a 32 GB de memória unificada é o nível mais confortável dentro da oferta da Apple: dá-te margem real para um modelo maior, um contexto mais longo ou, simplesmente, para manter outras aplicações abertas enquanto trabalhas. Escolhe 32 GB se contas usar isto com frequência e o orçamento o permitir.
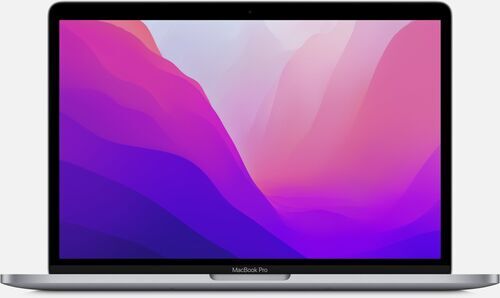
O MacBook Pro de 13 polegadas com chip M2 é um exemplo recondicionado bem concreto que já fica acima do patamar de entrada de 16 GB: combina um CPU de 8 núcleos e um GPU de 10 núcleos com até 24 GB de memória unificada. É uma geração de chip mais antiga do que a do Air M5, por isso o teto de 24 GB é o que deves esperar aqui, e não as opções separadas de 24/32 GB do Air M5.
Vais comprar um portátil novo com Windows ou Linux? Procura uma GPU dedicada.
Se vais comprar um portátil Windows ou Linux novo a pensar em IA local, procura 32 GB de RAM do sistema e uma GPU dedicada da NVIDIA para portáteis com pelo menos 8 GB de VRAM própria, ou 12 GB se aceitares um portátil um pouco mais pesado ou caro. Os 8 GB são um objetivo plausível para modelos de 4-7B em precisão Q4 com contexto moderado, mas não assumas que isso garante folga automática: mesmo um download de 6,6 GB para um modelo 9B em Q4 pode precisar de mais do que 8 GB para correr com conforto, e 12 GB simplesmente facilitam os testes nessa dimensão.
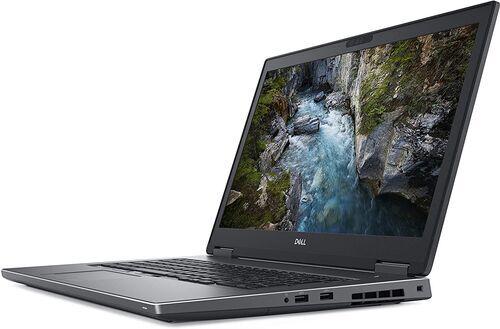
O Dell Precision 7730 é um exemplo recondicionado real desta ideia de base, mesmo que não use os chips novos mencionados acima: junta 32 GB de memória do sistema a uma NVIDIA Quadro P3200 dedicada com 6 GB de VRAM própria, uma geração e categoria de GPU diferentes das atuais RTX 5060 e 5070 Ti Laptop GPU da NVIDIA, mas com o mesmo princípio de memória separada.

Uma alternativa a ter em conta: chips AMD para portáteis com muita memória
O processador Ryzen AI Max+ 395 da AMD suporta até 128 GB de memória LPDDR5x do sistema, consoante a configuração do portátil final. É uma arquitetura de memória diferente que vale a pena conhecer, mas tem uma limitação importante: a lista de suporte ROCm para Linux do Ollama inclui este chip, enquanto a lista ROCm para Windows, de momento, não o inclui.
Isso é motivo para verificares a memória instalada, o sistema operativo, o backend de GPU, o driver e o comportamento do Ollama num portátil específico antes de o recomendares, não uma razão para excluir logo o chip. Vê um portátil AMD com muita memória como uma arquitetura alternativa interessante, que merece pesquisa cuidadosa, e não como a compra padrão para quem está a dar os primeiros passos em IA local.
A camada de software: Ollama e LM Studio, sem complicações
O Ollama é a forma mais simples de pôr um modelo a responder no teu próprio computador: descarregas um modelo, corres esse modelo e ficas com um servidor local a responder a pedidos, sem precisares de uma conta na cloud para um modelo já descarregado. É a ferramenta por trás de todos os exemplos aqui.
O LM Studio oferece uma alternativa gráfica, com o seu próprio navegador de modelos e janela de conversa. Também publica os requisitos mínimos: pelo menos 16 GB de RAM em Mac ou Windows, suporte AVX2 obrigatório em Windows x64 e 4 GB de VRAM dedicada recomendados em Windows. Configurar bem qualquer uma destas ferramentas já é um tema à parte.
Um aviso antes de confiares em qualquer número isolado de velocidade que encontres online: a ferramenta oficial llama-bench separa a velocidade de processamento do prompt da velocidade de geração e mostra a variação entre testes repetidos, em vez de apresentar um único valor. Um número de tokens por segundo citado num fórum raramente explica qual das duas medições foi usada ou quantas vezes o teste foi repetido.
Checklist para comprar ou melhorar um portátil preparado para IA
Antes de comprares ou melhorares um portátil especificamente para IA local, confirma os detalhes concretos em vez de ficares pelo marketing.
Modelo exato da GPU e VRAM. Não basta o nome da família da GPU; importa a variante exata do portátil e a memória que traz, porque o mesmo nome pode esconder quantidades diferentes de VRAM.
RAM soldada ou expansível. Alguns portáteis permitem aumentar a memória mais tarde; muitos modelos finos e leves atuais não permitem. Convém saber qual estás a comprar.
Espaço livre em SSD. Os downloads de modelos vão de menos de 1 GB a bem mais de 10 GB, e uma coleção crescente ocupa espaço depressa, a par dos teus outros ficheiros.
Comportamento térmico em carga prolongada. Um modelo a responder a uma pergunta e um portátil a lidar com vários pedidos seguidos são testes diferentes; o ruído das ventoinhas e a redução de desempenho após prompts repetidos dizem-te mais do que uma demonstração rápida.
Suporte de sistema operativo e drivers. Confirma se a combinação exata entre o backend da GPU e o sistema operativo é suportada pelo Ollama ou pelo LM Studio antes de partires do princípio de que sim.
O número de TOPS da NPU na caixa não garante débito real. É um valor de marketing, não um resultado testado no motor que vais usar. Um rótulo vago de "AI PC" não substitui nenhuma das verificações acima.
Cinco portáteis recondicionados que já encaixam nestes níveis

Perguntas frequentes sobre correr IA num portátil
Preciso de uma GPU dedicada para correr IA localmente?
Não. Um modelo pequeno consegue correr na CPU ou nos gráficos integrados de muitos portáteis com 16 GB, apenas com mais variação de velocidade do que num portátil com GPU dedicada. Começa por um modelo de 2-4B antes de assumires que precisas mesmo de gráficos dedicados.
8 GB de RAM chegam?
Não com conforto, pelo menos para os modelos abordados aqui. Os 16 GB são o ponto de partida realista quando tens em conta que o modelo, a janela de contexto, o motor e o sistema operativo partilham todos a mesma memória.
Correr um modelo localmente é o mesmo que treiná-lo?
Não. Tudo o que foi descrito acima é inferência: fazer perguntas a um modelo já treinado. O treino cria um modelo a partir do zero e exige muito mais hardware do que qualquer portátil aqui referido.
Mais RAM garante respostas mais rápidas?
Não. Mais memória dá margem para modelos maiores, contexto mais longo e mais aplicações abertas, mas a velocidade real depende da largura de banda da memória, do backend da GPU e do modelo específico, não apenas da capacidade de memória.
Os meus dados ficam privados quando o modelo corre localmente?
Sim, no sentido em que os teus prompts ficam na tua máquina em vez de seguirem para um fornecedor de cloud. Por defeito, o Ollama fica associado ao teu próprio portátil e não envia pedidos para mais lado nenhum, a menos que configures deliberadamente um acesso à cloud.
Experimenta esta noite e depois compra com confiança
Já tens um portátil com 16 GB? Instala o Ollama hoje e corre um modelo pequeno antes de gastares um cêntimo em algo novo. Vais comprar um portátil especificamente para isto? Usa a checklist acima e os cinco portáteis recondicionados que acabaste de ver como ponto de partida para comparar, em vez de confiares apenas numa ficha de marketing.
Todos os portáteis na refurbed são testados e classificados antes de entrarem na plataforma, por isso a RAM e a configuração que compras são mesmo as que recebes. O próximo guia desta série explica como ligar a tua primeira aplicação ao modelo que acabaste de experimentar.


Subscreve a nossa newsletter pela primeira vez e poupa 15€!
Não percas mais nenhuma oferta.
Informações sobre o uso de dados pessoais podem ser encontrados na nossaPolítica de Privacidade.
Faz o download da app refurbed
Para iOS e Android


Confirmar registo
Clica no link do nosso e-mail de confirmação para receberes o teu voucher. É aplicável em compras a partir de €200.
- © Refurbed Marketplace GmbH
- Acessibilidades
- T&C
- Política de privacidade
- Ficha técnica
- Informações Legais
- European Data Act
- Cookie Policy