Os melhores modelos pequenos de IA para correr no teu portátil: um kit compacto
Num portátil comum com 16 GB, o qwen3.5:4b-q4_K_M já responde a perguntas sem qualquer ligação à internet. É o mesmo modelo da segunda parte desta série e um bom assistente generalista. Mas não é o indicado para pesquisar nos teus ficheiros nem para tratar de tarefas de programação. Se descarregares um único modelo para tudo, acabas por sobrecarregá-lo, em vez de teres três modelos pequenos, cada um com uma função que justifica a escolha.
Controlar uma instalação de IA local implica decidir que modelo usar, com que motor o executar, ao abrigo de que licença e onde ficam os dados. Se ainda não sabes quanta RAM ou VRAM tem o teu portátil, começa pelo guia sobre quanta RAM precisa o teu portátil para IA local. Se ainda não instalaste o Ollama, configura o teu primeiro fornecedor de IA local. Partimos do princípio de que já fizeste ambas as coisas. A pergunta agora é: que modelos escolher e como saber se são bons?
Os melhores modelos pequenos de IA local para cada tarefa
Para teres um kit de IA local útil, precisas de cobrir três tarefas distintas, não de obrigar um só modelo a fazer tudo.
Um assistente generalista, para conversar, preparar rascunhos e responder a perguntas rápidas: qwen3.5:4b-q4_K_M, com uma transferência de 3,4 GB. É o mesmo identificador usado na segunda parte.
Um especialista compacto, para uma tarefa mais delimitada, como produzir respostas estruturadas ou resolver problemas de raciocínio com restrições: granite4.2:3b, uma transferência de 2,2 GB. O modelo tem licença Apache 2.0 e foi lançado em agosto de 2026. Na secção 6, encontras outras opções para programação, matemática, análise de imagens e tradução, para escolheres o especialista adequado à tua tarefa.
Um modelo de embeddings, para pesquisar nos teus próprios documentos: embeddinggemma:300m, com uma transferência de 622 MB. Não é um modelo de conversação: converte texto em vetores que uma aplicação de pesquisa pode consultar, como explicamos na secção 8.
No total, as três transferências ocupam cerca de 6,2 GB em disco. Mas esse valor não corresponde à memória necessária para manter os três modelos carregados em simultâneo, que pode exceder a memória livre do portátil. O melhor é carregar um modelo de cada vez, consoante a tarefa, avaliá-lo num caso real e remover os que não justifiquem o espaço que ocupam.
O que muda quando quantizas um modelo
É mais fácil perceber o efeito da quantização comparando versões do mesmo modelo. No catálogo do Ollama, a transferência de qwen3.5:9b-q4_K_M ocupa 6,6 GB, a de qwen3.5:9b-q8_0 ocupa 11 GB e a de qwen3.5:9b-bf16, 19 GB. Os mesmos pesos, três níveis de precisão e três tamanhos de transferência.
São tamanhos de transferência indicados no catálogo, não garantias quanto à memória ocupada durante a execução. Menos precisão significa menos espaço em disco e, muitas vezes, menos memória para manter o modelo carregado. Mas a perda de qualidade das respostas depende do modelo, do quantizador e da tarefa: não a descartes à partida nem pressuponhas que poupar espaço não tem custos.
Os pesos carregados não são tudo. Ainda é preciso reservar memória para a janela de contexto e a sua cache de chaves e valores, além dos restantes programas em execução. Reduzir a memória necessária por meio da quantização não garante que caiba um modelo maior; só torna essa tentativa mais viável do que começar pelo ficheiro de precisão total.
Dois nomes que te podem levar a descarregar o modelo errado
É fácil interpretar mal dois nomes deste catálogo e acabar a descarregar um modelo diferente do pretendido.
Primeira armadilha. A ficha da Google descreve o Gemma 4 E2B como tendo 2,3 mil milhões de parâmetros de linguagem «efetivos». Pode parecer um ficheiro pequeno, mas a transferência no Ollama ocupa 7,2 GB, quase tanto como os 7,6 GB do gemma4:12b em Q4. Para saberes o que cabe no teu portátil, consulta o tamanho da transferência, não te guies pelo número de parâmetros no nome.
Segunda armadilha. Um identificador sem a versão pode levar-te ao modelo errado sem dares por isso. Ao descarregar apenas granite4.2, obténs o modelo 8B de 5,3 GB, e não a versão 3B de 2,2 GB da secção 2. Com qwen3-embedding, obténs o modelo 8B de 4,7 GB, e não a versão 0,6B de 639 MB usada na secção 8.
Nos dois casos, faz o mesmo: usa o identificador completo e exato, nunca apenas o nome da família, e confirma o tamanho da transferência antes de concluir que descarregaste o modelo que querias testar.
A janela de contexto predefinida no Ollama
Um limite anunciado no catálogo, como 128K ou 256K tokens, indica quantos tokens o modelo aceita em teoria. Não significa que haja memória suficiente para os usar num portátil com 16 GB.
Por defeito, o Ollama define uma janela de contexto de 4096 tokens. Podes aumentá-la, mas uma janela maior e mais pedidos em paralelo consomem mais memória. O valor num_ctx: 4096 da segunda parte da série corresponde a essa definição prudente, não a um número redondo escolhido ao acaso.
Ao testar um modelo novo, começa por definir entre 4K e 8K tokens, com uma única sessão de cada vez, e acompanha o consumo de memória do sistema. Só aumenta o contexto depois de confirmares que a memória se mantém estável, não por o catálogo dizer que o modelo o suporta em teoria.
Que modelo pequeno de IA escolher para cada tarefa?
Não há um único especialista que seja o melhor em tudo. Há, isso sim, alguns modelos pequenos que vale a pena testar na tarefa que tens em mãos.
Programação: qwen2.5-coder:3b (1,9 GB) ou qwen2.5-coder:7b (4,7 GB), o maior dos dois. Ambos têm licença Apache 2.0.
Matemática ou lógica com restrições: phi4-mini:3.8b (2,5 GB), da Microsoft.
Perguntas sobre imagens ou capturas de ecrã: gemma4:e2b (7,2 GB) ou gemma4:12b Q4 (7,6 GB). Ambos têm licença Apache 2.0 e as respetivas fichas indicam que aceitam texto e imagem.
Escrita multilingue ou tradução: aya-expanse:8b (5,1 GB), concebido para 23 línguas.
Aqui, a licença exige atenção: o Aya Expanse 8B destina-se a uso não comercial, ao abrigo da licença CC-BY-NC-4.0 e de termos adicionais. Não o trates como uma opção sem restrições ao lado dos modelos com licença Apache referidos acima. Se nenhuma destas quatro opções corresponder à tua tarefa, granite4.2:3b, da secção 2, continua a ser a escolha generalista para raciocínio.
Testa-os na tua própria tarefa antes de escolheres. Um especialista, tal como o assistente, justifica o espaço que ocupa se te ajudar a fazer o que lhe pediste, não por estar no topo da tabela de classificação de outra pessoa.
Testa antes de confiar: cinco tarefas que podes repetir
Cinco testes curtos dizem-te mais sobre um modelo do que qualquer página de catálogo. Faz os mesmos cinco testes com cada candidato, usando material teu.
1. Um resumo apoiado no texto. Dá ao modelo uma nota de 250 palavras e pede-lhe três tarefas a realizar, cada uma acompanhada da frase que a justifica. Assinala tudo o que disser sem fundamento no texto.
2. Extração estruturada. Inventa cinco compromissos com nomes e datas. Pede ao modelo uma resposta em JSON com exatamente os campos que definiste e compara os cinco resultados com o que escreveste.
3. Correção de código. Dá-lhe uma função curta que falha e um teste. Depois da correção, verifica se o teste passa, mantendo o mesmo repositório e o mesmo contexto para todos os modelos comparados.
4. Um par de línguas. Pede a uma pessoa fluente que verifique se a tradução de um parágrafo realista conserva os nomes, os números e as nuances. Não avalies a qualidade multilingue apenas com instruções em inglês.
5. Uma pergunta sobre uma imagem, apenas para modelos capazes de analisar imagens. Mostra um gráfico ou uma captura de ecrã cuja resposta possas verificar e confirma que enviaste a imagem, não apenas o nome do ficheiro.
Em cada teste, regista se o modelo acertou na resposta que já conhecias, se seguiu as instruções, o que inventou, o tempo até ao primeiro resultado visível, o tempo total, as contagens de tokens e se correu em CPU ou GPU. Avalia a utilidade e a rapidez separadamente: um modelo que raciocina antes de responder pode gastar tempo a gerar tokens que não chegas a ver.
Uma pequena extensão para pesquisar documentos com RAG local
O modelo de embeddings da secção 2 serve para converter texto em vetores que uma aplicação de pesquisa pode consultar. Não responde sozinho a perguntas.
A ordem importa. Primeiro, os teus ficheiros são divididos em excertos. Depois, um modelo de embeddings converte cada excerto num vetor, que fica guardado num repositório vetorial local. A tua pergunta também é convertida num vetor e os excertos mais próximos são recuperados. Só então um modelo de conversação responde com base nesses excertos e cita as passagens utilizadas.
O modelo de conversação não foi treinado com os teus documentos: só vê aquilo que a pesquisa lhe entrega no momento em que fazes a pergunta.
Podes testar o princípio sem grande preparação. Indexa cinco notas que já tenhas e faz duas perguntas: uma cuja resposta esteja numa delas e outra a que nenhuma das cinco responda. Se tudo funcionar, o sistema recupera e cita a passagem certa na primeira e, na segunda, reconhece que não tem informação que sustente uma resposta, em vez de a inventar. Avalia separadamente a recuperação dos excertos e a resposta final.
Antes de descarregares o modelo de embeddings, confirma o identificador completo: embeddinggemma:300m ou qwen3-embedding:0.6b. É a mesma precaução contra identificadores incompletos explicada na secção 4.
Menos parâmetros ativos não significam menos dados para guardar
Uma designação como «26B A4B» significa que o modelo só ativa parte dos parâmetros para gerar cada token. Ainda assim, é preciso guardar algures os pesos dos 26B parâmetros, ou lê-los em fluxo. Ter menos parâmetros ativos não equivale a um ficheiro mais pequeno nem a menos memória ocupada.
Este kit não apresenta resultados de novos testes de desempenho. Quando surge um valor de outra fonte, como os cerca de 18,5 tokens por segundo relatados por uma pessoa numa configuração pouco habitual de um modelo 26B de mistura de especialistas, com um CPU antigo e uma GPU de 6 GB, trata-se de um resultado individual, obtido naquele computador. Não é uma previsão para todos os modelos com essa designação.
Os portáteis usados como referência para este kit
Este kit foi testado em dois portáteis reais e atuais, os mesmos da segunda parte da série: um modelo Apple Silicon de entrada e uma estação de trabalho Windows com memória gráfica dedicada. Ambos são recondicionados: foram testados, limpos e recondicionados por profissionais e têm uma garantia de 12 meses na refurbed. Em qualquer um deles, é possível correr confortavelmente este kit, um modelo de cada vez.
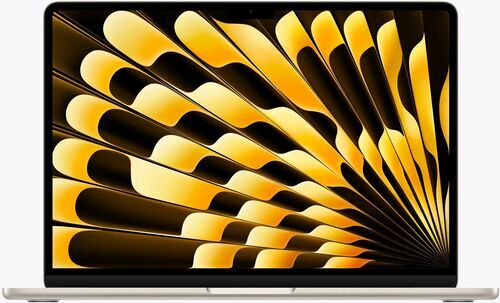
O MacBook Air (2026) de 13 polegadas com chip M5 vem de série com 16 GB de memória unificada e pode ser configurado até 32 GB. O Dell Precision 7730 tem 32 GB de memória do sistema e 6 GB de VRAM NVIDIA dedicada: são memórias separadas, não um único valor somado.
Não os apresentamos como argumento de venda. Serviram de referência a este guia, para poderes comparar o teu portátil com máquinas concretas em vez de te guiares por uma ficha de características publicitária.

Confirma as licenças e revê a tua seleção de modelos
A licença aplica-se ao modelo específico, não à família inteira. Qwen3.5 4B, Qwen2.5-Coder, Granite 4.2 3B e Gemma 4 E2B têm licença Apache 2.0. Aya Expanse 8B tem licença CC-BY-NC-4.0, com termos adicionais, para uso não comercial, como vimos na secção 6. Poder descarregar os pesos, ter permissão ao abrigo dos direitos de autor para os usar e ser «dono» do modelo são coisas distintas. Consulta a ficha atual do modelo exato que descarregares, não apenas a da família.
Um kit pequeno mantém-se pequeno com revisões regulares, não apenas com uma escolha inicial. O comando ollama rm remove um modelo descarregado que não justificou o espaço que ocupa; por exemplo, ollama rm aya-expanse:8b, se já souberes que não o vais usar. ollama ls mostra os modelos guardados em disco; ollama ps mostra os que estão carregados. Como os catálogos mudam, revê a tua seleção em vez de te fiares numa escolha feita há meses.
Mesmo os modelos pequenos podem inventar uma passagem, não captar uma nuance noutra língua ou escrever código que parece correto mas falha o teste. Encara cada recomendação deste guia como uma experiência que podes fazer por ti, nunca como substituto de uma avaliação especializada quando o assunto é importante.
Perguntas frequentes sobre modelos pequenos de IA local
Posso executar os três modelos do kit ao mesmo tempo? Num portátil com 16 GB, provavelmente não de forma confortável. Carrega o modelo de que precisas para a tarefa em mãos e troca-o quando passares a outra, em vez de manteres carregados o assistente generalista, o especialista e o modelo de embeddings ao mesmo tempo.
Preciso de uma GPU para o modelo de embeddings? Não. O embeddinggemma:300m é suficientemente pequeno para ser testado só com CPU, embora valha a pena medir o tempo em vez de presumir que é instantâneo.
Um modelo maior dá sempre respostas melhores? Não. O desempenho de um modelo 4B face a um 9B depende da tarefa. É por isso que a secção 7 propõe cinco testes, em vez de reduzir a comparação a um único número de uma tabela de classificação.
Uma transferência Q4 é suficiente? Depende da tarefa. Se tiveres memória para executar ambas as versões, compara a Q4 com a Q8 do mesmo modelo em três testes teus, como na secção 3.
Posso usar o Aya Expanse num projeto comercial? Não por defeito. A licença CC-BY-NC-4.0 cobre o uso não comercial e inclui termos adicionais. Consulta a ficha atual do modelo antes de assumires que podes usá-lo para fins comerciais.
O modelo de embeddings precisa de internet depois de descarregado? Não. Tal como os outros modelos deste kit, funciona sem ligação à internet assim que os pesos estejam guardados em disco.
Agora é contigo: instala, testa e fica só com o que vale a pena
Instala o assistente 4B e um especialista adequado a uma tarefa tua no portátil que a primeira parte te ajudou a dimensionar e a segunda a configurar. Faz a tua própria versão dos testes da secção 7, com três perguntas. Fica com o modelo que te for útil e remove o outro com ollama rm. Só pondera comprar mais memória quando uma tarefa real, e não uma ficha técnica, te mostrar que esse é o limite.
Chegamos ao fim desta série de três partes. Se o teu portátil precisar primeiro de mais capacidade, a categoria de portáteis é um ponto de partida sensato.

Subscreve a nossa newsletter pela primeira vez e poupa 15€!
Não percas mais nenhuma oferta.
Informações sobre o uso de dados pessoais podem ser encontrados na nossaPolítica de Privacidade.
Faz o download da app refurbed
Para iOS e Android


Confirmar registo
Clica no link do nosso e-mail de confirmação para receberes o teu voucher. É aplicável em compras a partir de €200.
- © Refurbed Marketplace GmbH
- Acessibilidades
- T&C
- Política de privacidade
- Ficha técnica
- Informações Legais
- European Data Act
- Cookie Policy